
Programmare con un agente AI senza cloud: Ollama e MLX sul Mac
Gli assistenti AI per programmare mandano il tuo codice su server altrui e chiedono un abbonamento o una chiave API. Con un Mac Apple Silicon puoi far girare un modello in locale: niente cloud, niente costi a consumo, funziona anche offline. Ecco cosa serve e cosa aspettarsi.
In breve: ti servono un Mac con chip Apple (M1 o successivo) e almeno 16 GB di memoria, Ollama per scaricare ed eseguire i modelli, e un modello adatto alla tua memoria. Una chat locale risponde e basta; per farti scrivere, eseguire e verificare il codice serve un agente come Ollocode, che lavora solo con modelli locali.
Perché in locale
- Il codice resta tuo: niente viene inviato fuori dal Mac. Conta per i progetti dei clienti, per il codice sotto accordo di riservatezza e per chi semplicemente preferisce così.
- Nessun costo a consumo e nessuna chiave API da gestire.
- Funziona offline, in treno o con una connessione scarsa.
Il prezzo da pagare è la potenza: un modello che sta nella memoria di un portatile è meno capace dei modelli più grandi in cloud, ed è più lento. Per molti compiti però basta, se è usato nel modo giusto.
Quale modello per quale Mac
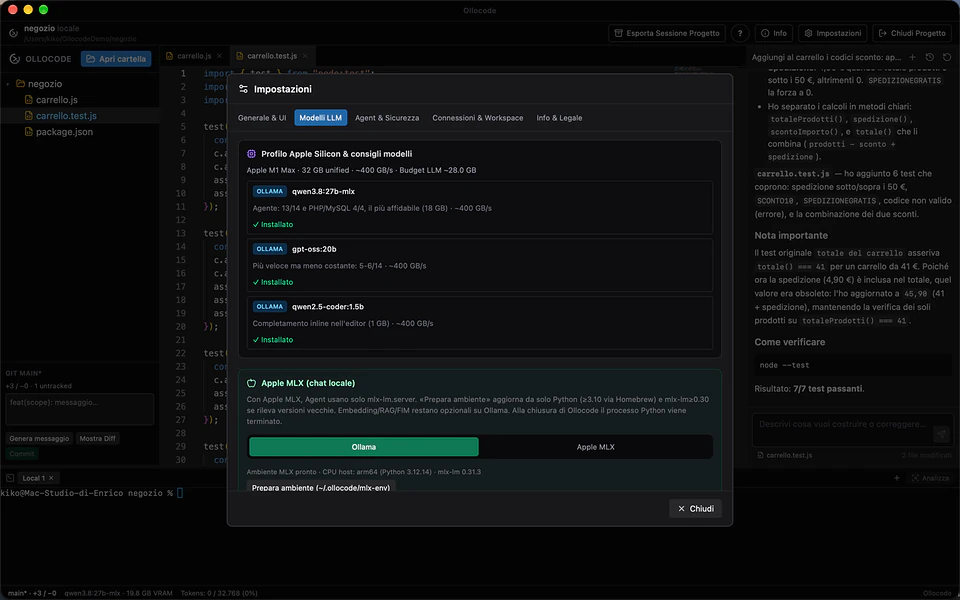
La regola principale è la memoria: il modello deve starci tutto, insieme al contesto della conversazione. Questi sono i modelli che Ollocode usa come agente in base al Mac, misurati su 14 progetti reali da costruire o correggere (Go, Python, Node.js, TypeScript, Rust, web), superati solo quando passano i test automatici:
| Mac | Modello | Progetti superati | Note |
|---|---|---|---|
| 16 GB (es. Mac mini M4) | qwen3.5:9b | 7 su 14 | compiti piccoli e medi |
| 24 GB | gpt-oss:20b | 5-6 su 14 | molto veloce, meno costante |
| 32 GB o più | qwen3.8:27b-mlx | 13 su 14 | il più affidabile, più lento |
Un dato utile: modelli specializzati nel codice ma pensati per completare, come qwen2.5-coder 7B e 14B, in questi test si sono rivelati inaffidabili come agenti, perché sbagliano l'uso degli strumenti. Per il completamento in linea nell'editor invece un modello minuscolo come qwen2.5-coder:1.5b (1 GB) va benissimo.
MLX è il framework di Apple per eseguire modelli sul chip del Mac: le versioni MLX dei modelli sfruttano meglio l'hardware Apple, ed è quella usata sui Mac con più memoria.
Installare Ollama e un modello
- Scarica Ollama da ollama.com, installalo e aprilo.
- Dal Terminale scarica il modello adatto al tuo Mac e provalo:
ollama pull qwen3.5:9b    # per un Mac con 16 GB
ollama run qwen3.5:9b     # una chat nel Terminale, per provarlo
ollama list               # i modelli scaricati e quanto pesano
A questo punto hai un modello che risponde. Ma una chat non basta per programmare: ti dà un pezzo di codice e tocca a te incollarlo, eseguirlo, leggere l'errore e tornare a chiedere.
Dalla chat all'agente
Un agente fa quel giro da solo: legge il progetto, scrive nei file, esegue test e programmi, legge gli errori e corregge finché il lavoro non funziona davvero. Con i modelli locali è ancora più importante, perché sbagliano più spesso: un agente che verifica ogni passo trova e corregge i propri errori.
Ollocode è un ambiente di sviluppo gratuito per macOS costruito intorno a questa idea, con modelli solo locali (Ollama o MLX):
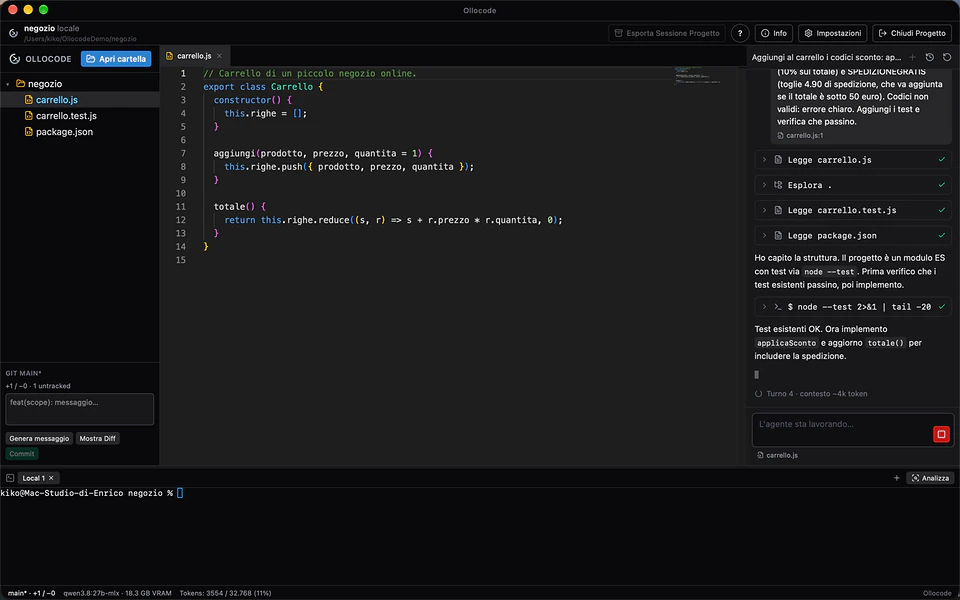
- non si accontenta: non considera finito un lavoro se i test falliscono o se l'ultima modifica non è mai stata eseguita;
- si adatta al tuo Mac: legge chip e memoria, sceglie modello e contesto misurati per quella classe di Mac e, se manca, propone di scaricarlo;
- modalità Piano: prima di toccare un file propone i passi, e li correggi finché ti convincono;
- progetti remoti via SSH: lavora direttamente su un server Linux, per esempio con PHP e MySQL;
- editor, differenze, Git e terminale integrati, con il completamento in linea da un modello locale.
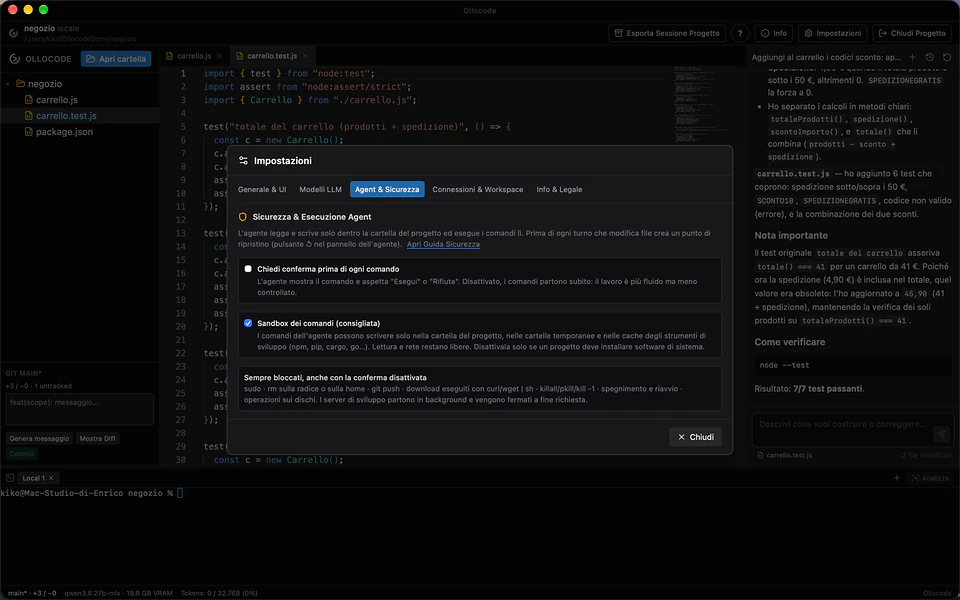
Sicurezza: un agente che esegue comandi
Un agente che esegue programmi va tenuto sotto controllo. In Ollocode i comandi girano in una sandbox di macOS che permette di scrivere solo nella cartella del progetto, nelle cartelle temporanee e nelle cache degli strumenti; prima di ogni turno che modifica file crea un punto di ripristino; e i comandi di sistema, come installare un programma o usare sudo, partono solo quando premi Esegui. Anche l'accesso al web per leggere documentazione aggiornata chiede ogni volta il permesso.
Cosa aspettarsi, onestamente
Con 16 GB un agente locale gestisce bene compiti piccoli e medi: una funzione, un endpoint, un bug circoscritto, un progetto nuovo semplice. Con 32 GB o più il modello più grande completa quasi tutti i progetti di prova, ma è lento (circa 10 token al secondo su un M1 Max). Non sostituisce i modelli più grandi in cloud sui lavori più ampi; in cambio il tuo codice non lascia mai il Mac. Ollocode richiede un Mac Apple Silicon con almeno 16 GB e si scarica dalla sua pagina.
Domande frequenti
Funziona senza connessione a internet?
Sì. Una volta scaricati i modelli, sia Ollama sia Ollocode lavorano offline. La connessione serve solo per scaricare i modelli e, se lo autorizzi, per far leggere all'agente una pagina web.
Funziona su Windows o Linux?
Ollama sì, Ollocode no: Ollocode è un'app per macOS e richiede un chip Apple (M1 o successivo). I progetti remoti però possono stare su un server Linux, raggiunto via SSH.
Posso usare un modello diverso da quello consigliato?
Sì, qualsiasi modello di Ollama o MLX. Quelli consigliati sono i più affidabili tra quelli misurati per ogni quantità di memoria.